第一阶段:LLM微调基础
目标:理解文档里提到的
LoRA(Low-Rank Adaptation,低秩适应)
QLoRA(Quantized LoRA)
SFT(Supervised Fine-Tuning,监督微调)
DPO(Direct Preference Optimization,直接偏好优化)
RLHF
vLLM
SFT、DPO
| 维度 | SFT | DPO |
|---|---|---|
| 训练数据 | 高质量的标准答案(input → output 对) | 偏好对比数据(input → chosen/rejected 对) |
| 学习信号 | 模仿标准答案(“这是什么”) | 学习相对偏好(“哪个更好”) |
| 优化目标 | 最大化生成标准答案的概率 | 最大化 chosen 优于 rejected 的边际 |
| 是否需要 Reward Model | 不需要 | 不需要(但隐式学习偏好) |
| 对齐效果 | 基础能力好,但容易过拟合或对齐不足 | 对齐人类偏好更直接,泛化性通常更好 |
输入特定类型的文本
监督微调
- SFT 像"抄作业":模型学习专家写好的标准答案,适合传授知识和基本格式。
- DPO 像"比较打分":模型学习"答案 A 比答案 B 更好",适合对齐人类价值观和偏好(如安全性、有用性、风格)
数据:
{
  "instruction":"把红色方块放进盒子",
  "output":"对应动作序列"
}
理解:
输入
↓
标签
↓
训练
实际训练中通常是先 SFT 后 DPO(或 RLHF):
- SFT 阶段:用高质量指令数据训练模型,让它学会基本对话格式和知识。
- DPO 阶段:用偏好数据(如人类标注的 good/bad 回答)进一步微调,让模型输出更符合人类偏好。
技术细节补充
- DPO 的优势:避免了 RLHF 中复杂的 Reward Model 训练和 PPO 强化学习,将偏好优化转化为简单的分类损失,训练更稳定高效。
- SFT 的局限:如果标准答案本身质量不够高或分布有偏,模型会学到错误模式;且无法表达"好答案"和"更好答案"之间的细微差别。
RLHF
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是大模型对齐阶段的核心方法,解决 SFT 无法表达"好/坏"偏好的问题。
SFT 的局限:
- 只知道"标准答案",不知道"A 比 B 更好"
- 无法处理开放性任务(如创意写作、多轮对话)
- 缺乏安全边界(可能生成有害内容)
RLHF 的目标:让模型输出更符合人类偏好
| |
训练 Reward Model(奖励模型)
| |
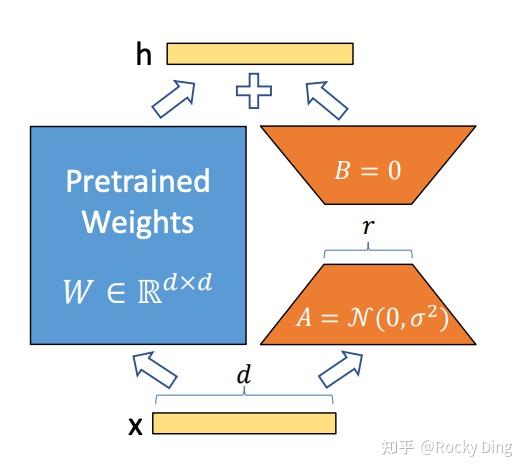
LoRA:
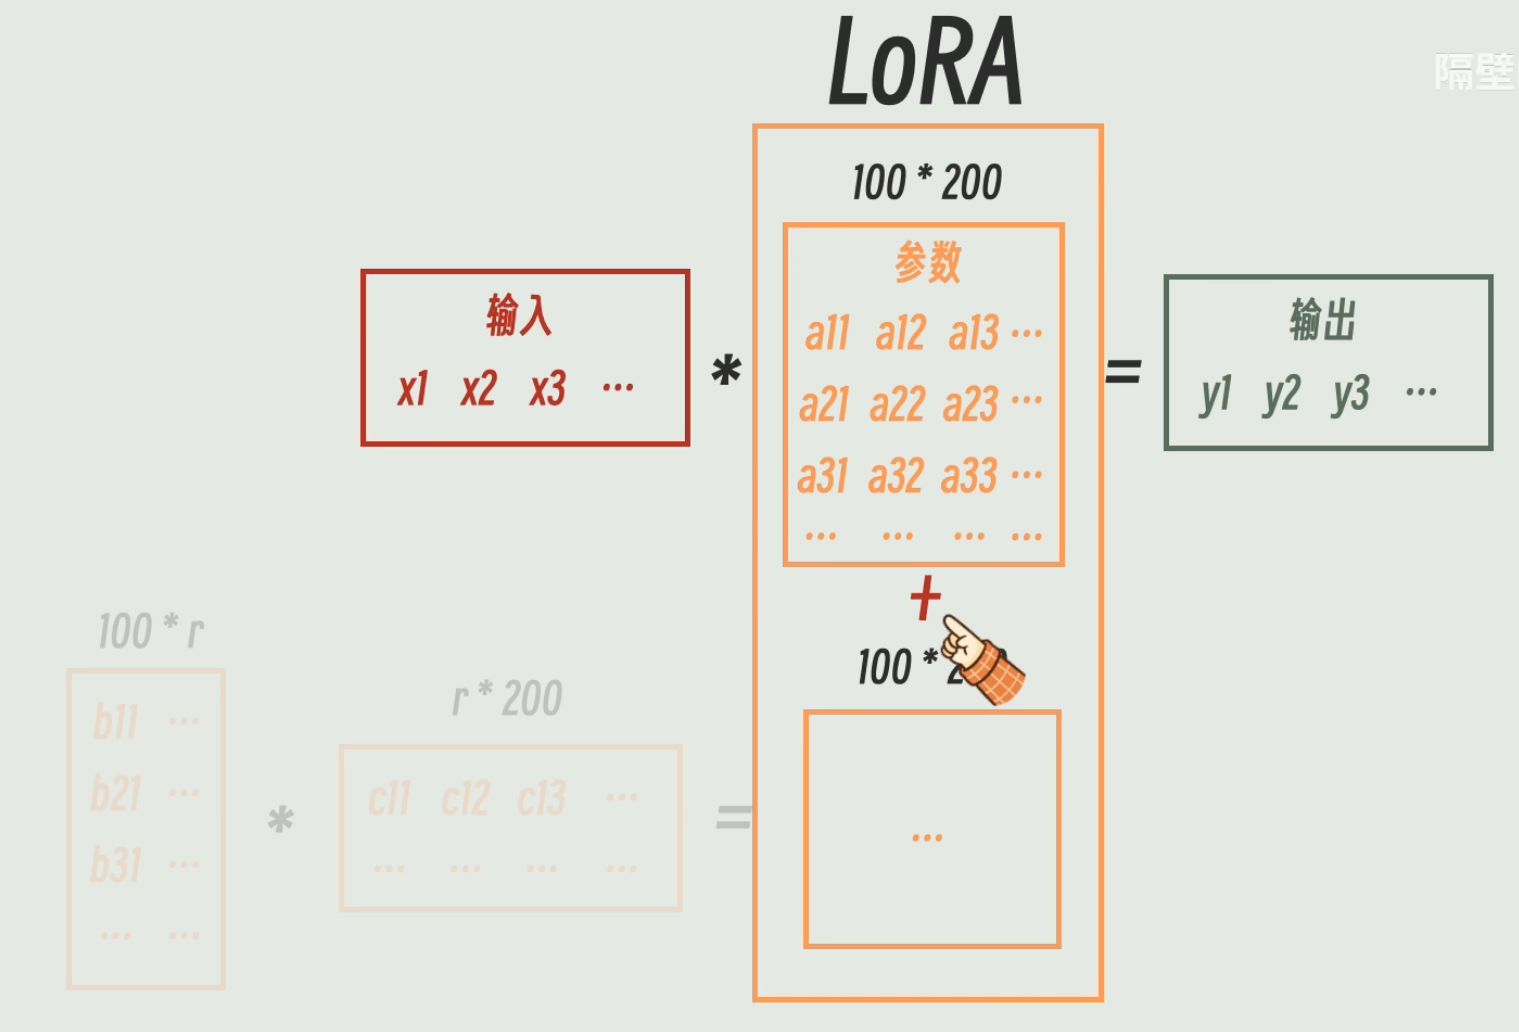
参数高效微调(Parameter-Efficient Fine-Tuning,PEFT)技术中的一种,冻结AIGC大模型的大部分参数,再引入一小部分可训练的参数作为适配模块进行微调训练
本质是特征矩阵进行低秩分解的一种近似数值分解技术,可以大幅降低特征矩阵的参数量,但是会伴随着一定的有损压缩,可以大幅降低特征矩阵的参数量,但是会伴随着一定的有损压缩
我们假设原来的是1001024的参数矩阵,那么参数量为102400,LoRA模型将矩阵拆成了两个矩阵相乘,如果我们设置Rank=8,那么就是1008的A矩阵与8*1024的B矩阵做矩阵乘法,参数量为800+8192=8992,整体参数量下降了约11.39倍
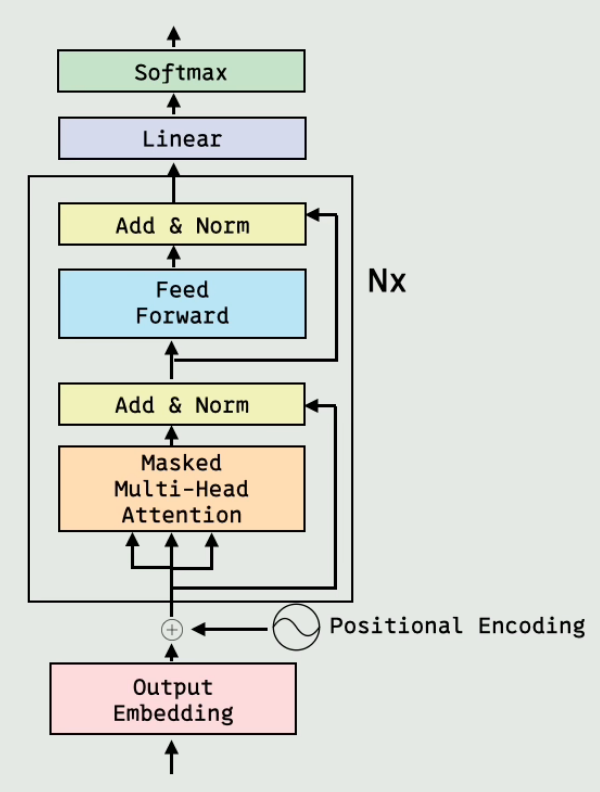
Transformer架构
比如attention模块就是
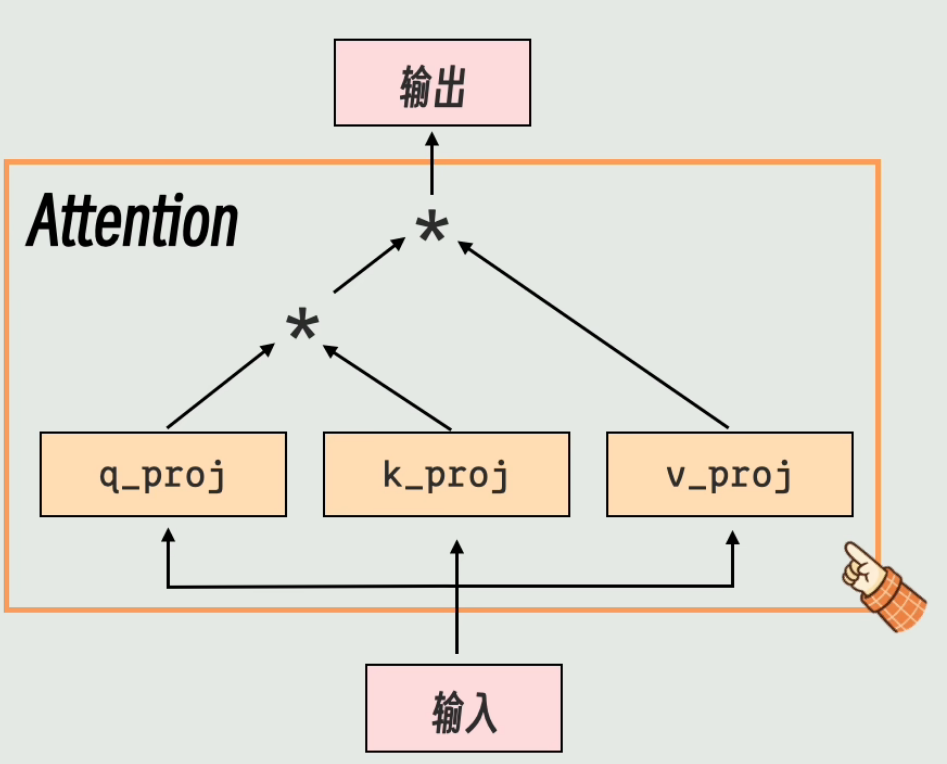
可以控制的就是这些矩阵,矩阵的值就是模型参数
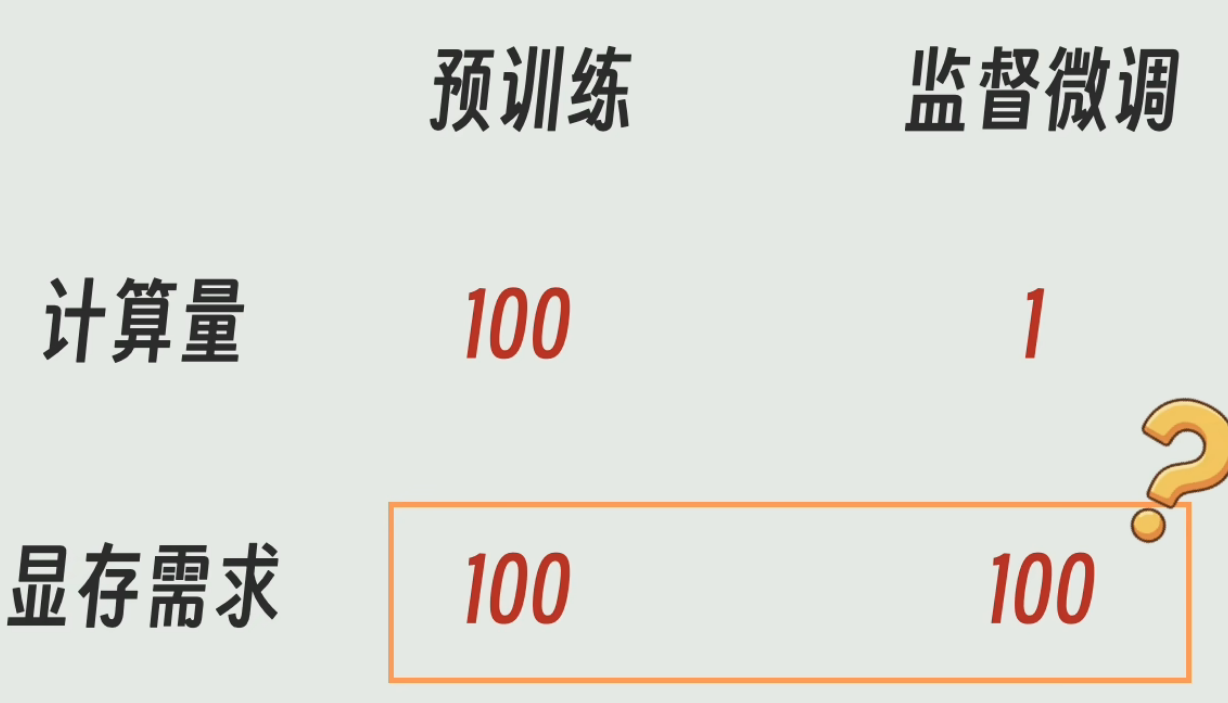
模型预训练:
把海量数据放入模型进行计算;
模型输出和期望输出通过数学方式比较,从而调整参数
模型微调
在预训练模型基础上,集中训练特定领域文本,让模型回复快速集中到特定领域
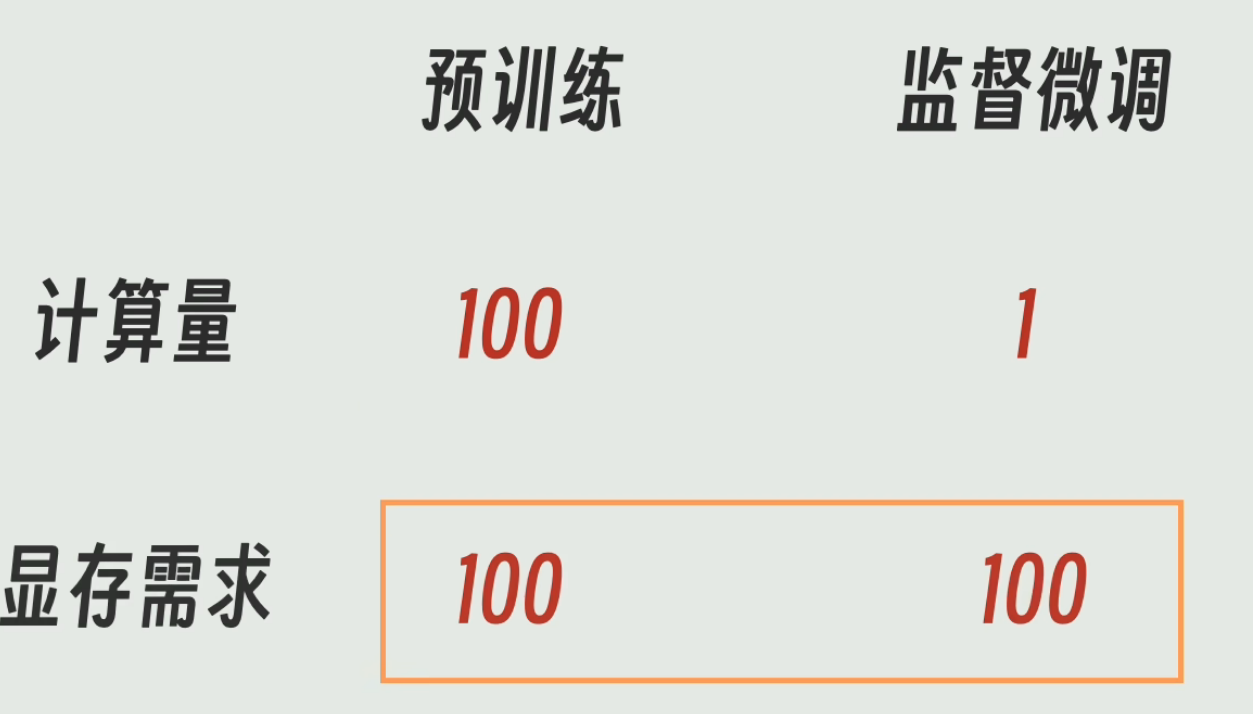
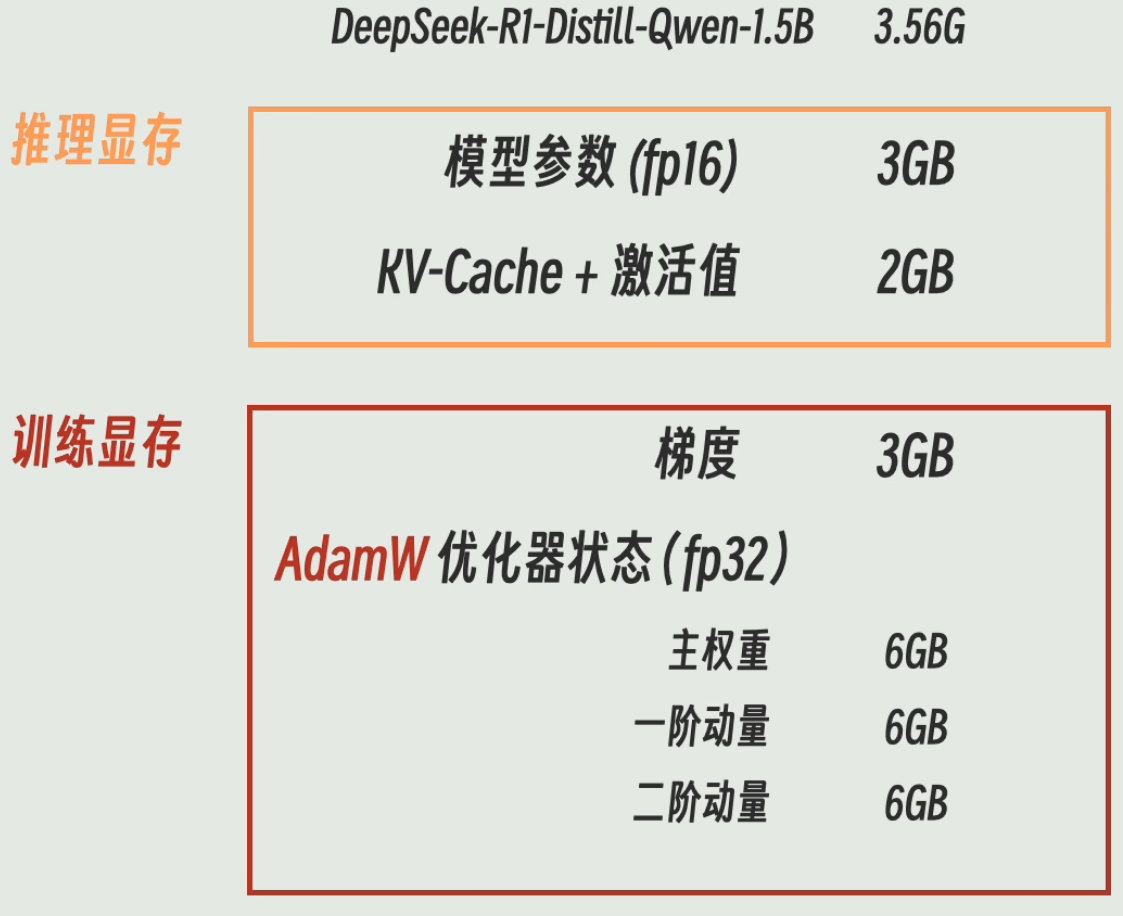
但监督微调sft显存占用与预训练模型一致
QLoRA(Quantized LoRA):
背景:模型量化(quantization)也被叫做模型的低精度表示,指的是在不大幅降低模型效果的前提下使用更低的精度来表示模型中的参数,从而缩减模型的体积和训练模型时占用的显存。量化的本质是函数映射,根据量化过程是否线性我们可以把量化分为线性量化和非线性量化。
即从一种数据类型“舍入”到另一种数据类型;量化操作不可避免的带来一些误差,例如从float32到int8的round操作带来的精度损失,超出int8范围的溢出值的截断
最常见的 量化技术是最大绝对值:
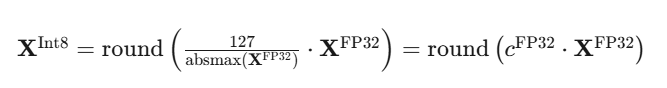
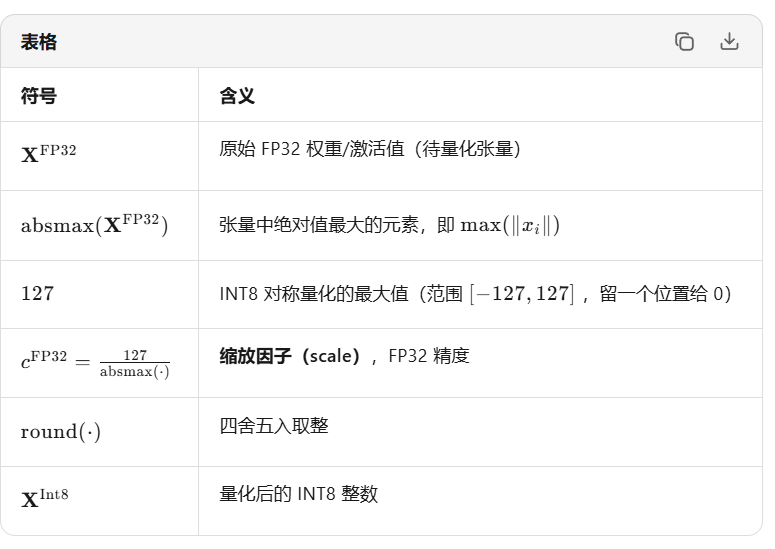
还有一种量化技术叫做零点量化:
第一步值域映射,即通过缩放将原始的数值范围映射为量化后的数值范围; 第二步零点调整,即通过平移将映射后的数据的最小值对齐为目标值域的最小值。
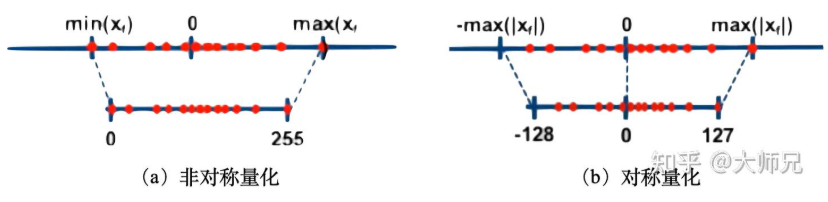
按照量化过程是否以0点为对称点量化又可以分为对称量化和非对称量化;
对称量化将原浮点数的最小或最大值的绝对值作为映射值的范围,而非对称量化是将原浮点数的最小和最大值映射为量化数据的最小和最大值,如图1。在非对称量化中,0的映射也可能会有偏移,因此不一定会被映射到0。
非线性量化:
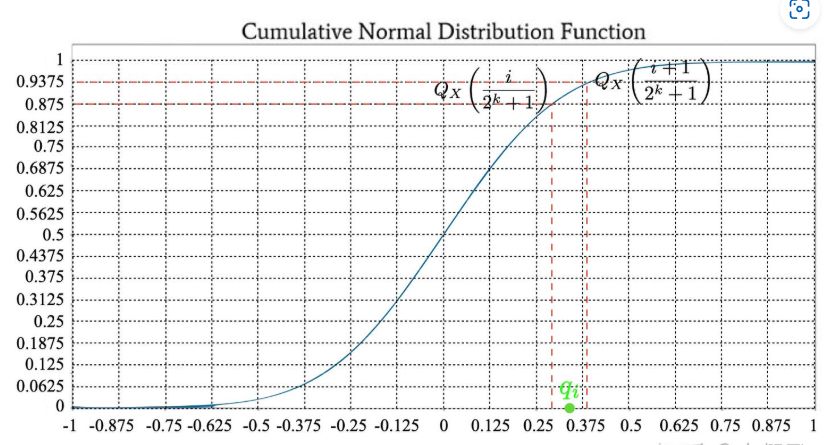
分位数量化(Quantile Quantization)顺序排列的一组数据分割为若干个相等块的分割点的数值
累积分布函数(CDF)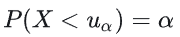 使用分位数将张量分成了大小相同的若干个块,这样我们得到更加均匀的量化特征,这也就是分位数量化。如图3所示,对于4比特量化,我们希望需要找到15个分位数来将这个曲线下面的面积(积分)等分成16份。两个分位数的中点便是模型量化到这个区间映射的值。预训练模型的参数往往是符合正态分布的,因此我们可以通过累积分布函数的反函数
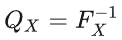
QLoRA
第一个工作是结合了分位数量化和分块量化的4位标准浮点数量化(4-bit NormalFloat Quantization)。第二个工作是对模型进行两次量化的双重量化(Double Quantization),它的第二次量化只作用在第一次量化产生的量化常数上,可以进一步节约显存占用。第三个工作是分页优化(Paged Optimizer),使用CPU内存代替GPU显存保存部分梯度参数。
一、分位数量化方法我们可以将FP2精度量化到4bit的精度,但是直接这么用的一个问题是不能保证高精度的0一定被映射到低精度的0,但是0点又是深度学习中一个重要的值,例如在模型稀疏化,数据padding的时候一般都是使用0来完成
二、保存模型时我们不仅要保存量化后的结果,还要保存每个块的量化常数。虽然量化后的参数只有4bit的精度,但是这个量化常量的精度是float32。在QLoRA中,每个块的大小是64,因为块中的每个值占4比特。这相当于为了存储量化常数,模型要额外占用12.5%
三、QLoRA分页优化其实就是当显存不足是,将保存的部分梯度检查点转移到CPU内存上,和计算机的内存数据转移到硬盘上的常规内存分页一个道理