端侧大模型在线/离线部署(Agent)——机器人项目迁移实战(三)

RK3588 迁移 Jetson Orin Nano 第三部分:Swap 与性能模式配置、llama.cpp/TensorRT-LLM 选型、Qwen2.5 量化与 GGUF 转换、ms-swift LoRA 微调、流式推理与 ROS2 节点集成。

在 Jetson Orin Nano 上部署大语言模型(LLM)是实现端侧大模型 Agent 的第一步,也是最核心的工程挑战。由于 Jetson 采用的是统一内存架构(Unified Memory Architecture),CPU 和 GPU 共享物理内存(4GB 或 8GB),这与传统 PC 的“内存+独立显存”有很大不同。在 Orin Nano 上,我们必须精细控制内存预算,防止系统因 OOM(Out of Memory)而崩溃。

针对子任务 3.1(离线版 - LLM 推理),从瑞芯微 RK 平台迁移到 NVIDIA Jetson 平台,我们需要将原有的 RKNN 链路彻底重构为 NVIDIA 生态的加速链路。

子任务 3.1 拆解:端侧 LLM 部署实施方案

✅️微任务 3.1.1:Jetson 硬件环境准备与 Swap 空间配置

  • 目标:解决 Orin Nano 在模型编译或高负载时内存不足的问题。
  • 具体步骤:

1.确认 JetPack 版本(推荐使用 JetPack 6.x,自带 CUDA 12.x 和更现代的 Linux 内核)。

1
2
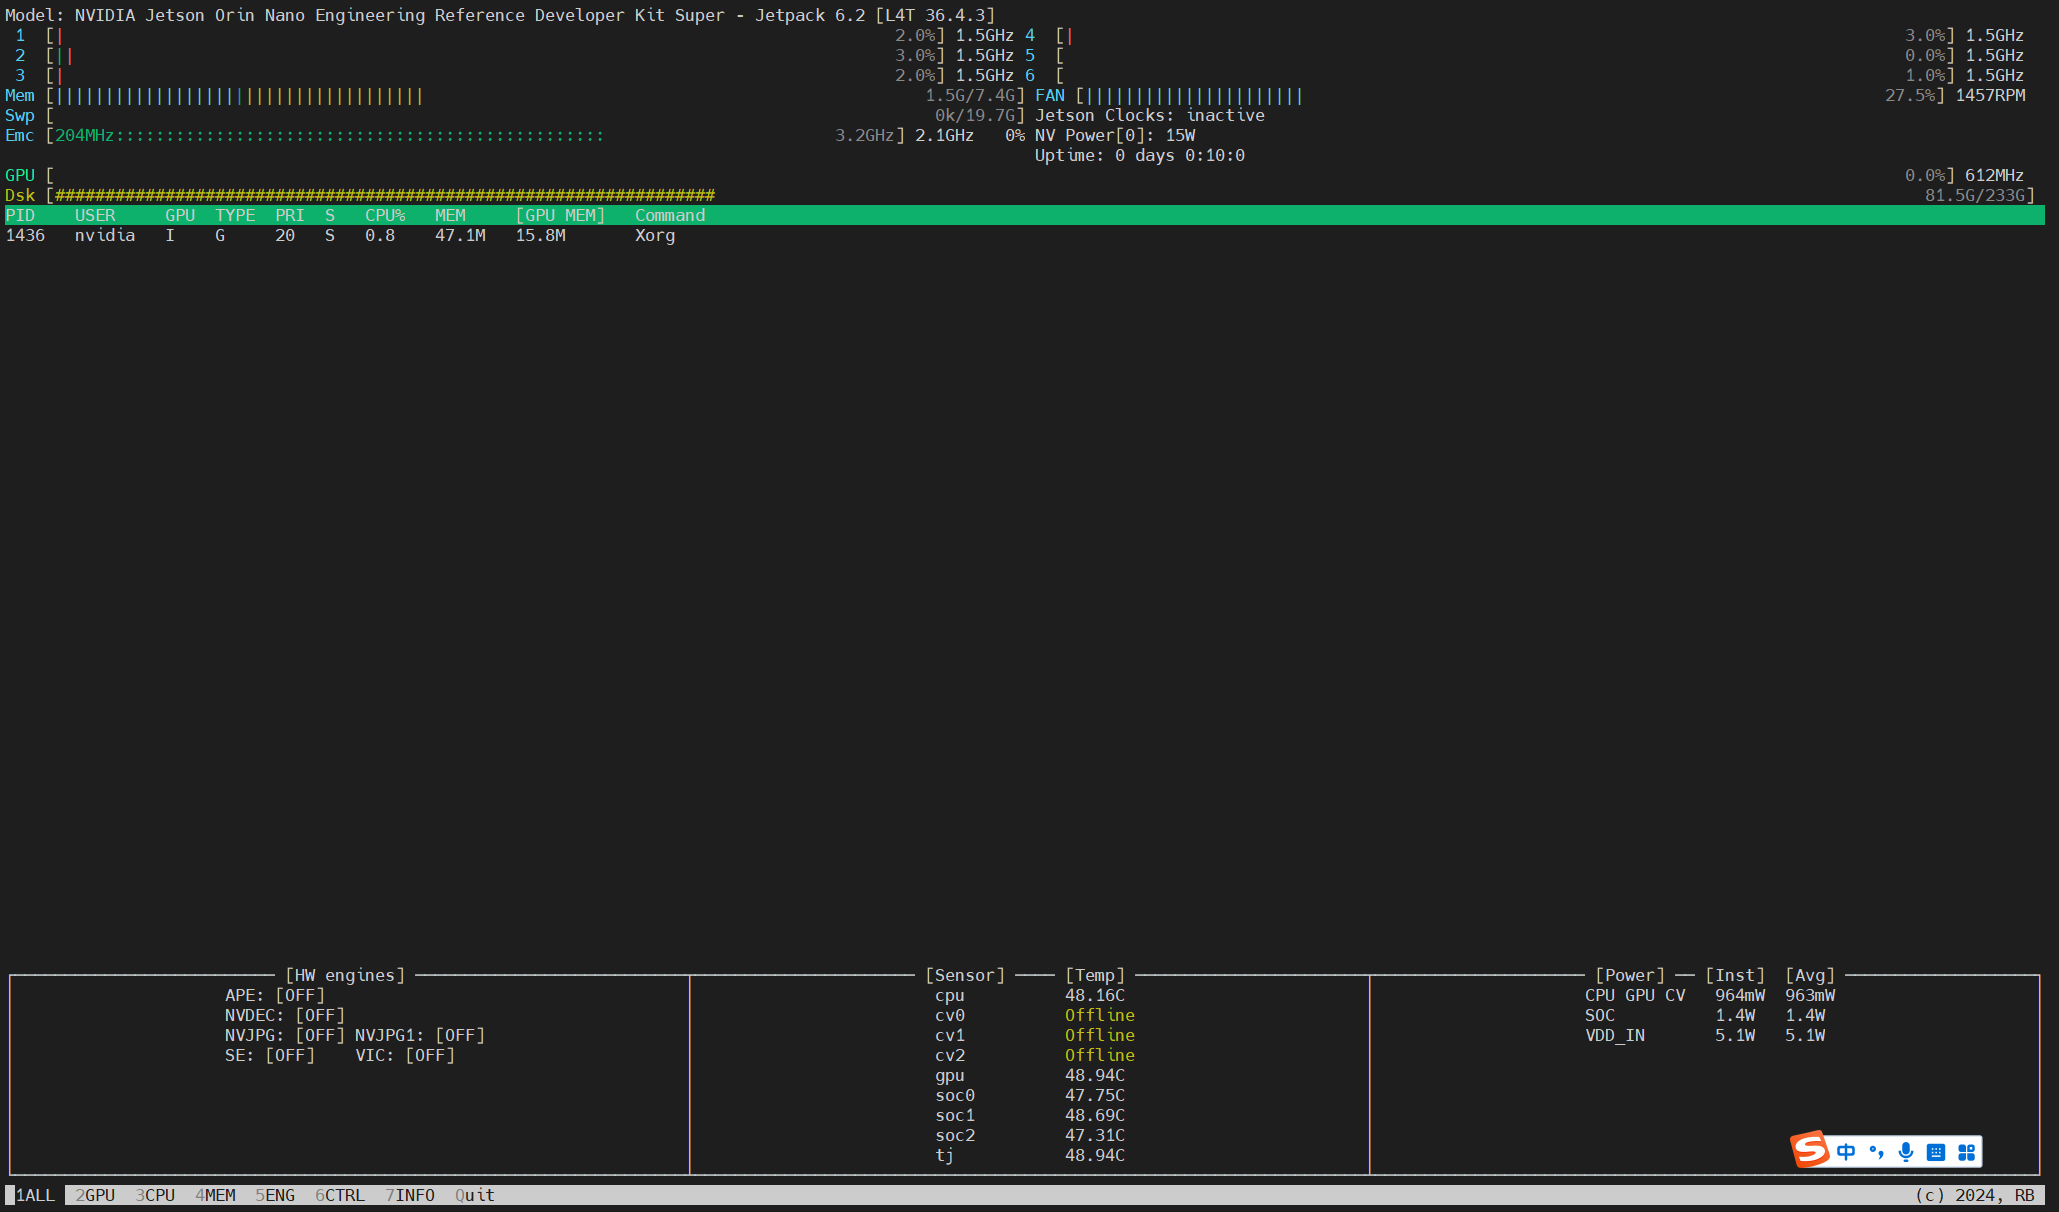
#jtop查看板卡信息
jtop
image-20260614205417498

2.必须配置虚拟内存(Swap):Orin Nano 即使是 8GB 版本,在编译模型或运行 4B 模型时也极易耗尽物理内存。建议通过 NVMe SSD 划分 16GB 的 Swap 空间。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
#查看内存和SWAP
free -h
#查看磁盘
lsblk
#创建swap
sudo fallocate -l 16G /swapfile
#设置权限
sudo chmod 600 /swapfile
#验证
ls -lh /swapfile
#格式化swap
sudo mkswap /swapfile
#启用swap
sudo swapon /swapfile
#插看swap
swapon --show & free -h
#开机自动挂载
sudo nano /etc/fstab
#末尾加入/swapfile none swap sw 0 0
#优化swap策略
cat /proc/sys/vm/swappiness
>60
sudo sysctl vm.swappiness=10
#永久生效
sudo nano /etc/sysctl.conf
#末尾加入vm.swappiness=10

3.开启最高性能模式:

1
2
sudo nvpmodel -m 0
sudo jetson_clock

锁住 CPU/GPU 频率,确保推理时延迟最低

✅️微任务 3.1.2:推理引擎技术选型(llama.cpp vs TensorRT-LLM)

  • 目标:根据开发周期和性能需求选择最佳引擎。
  • 方案对比与选择:
    • 方案 A:llama.cpp(推荐优先部署):对 Jetson 适配极佳,编译简单,内存开销极小。通过开启 GGML_CUDA=1,可以将计算完全卸载到 Orin Nano 的 Ampere GPU 上。支持 GGUF 格式,量化极其方便。
    • 方案 B:TensorRT-LLM(极致性能追求):NVIDIA 官方的王牌,吞吐量最高。但由于 TensorRT-LLM 的编译依赖较重,在 8GB 的 Orin Nano 上直接编译模型 Engine 极易 OOM,通常需要在 PC 端(带有 NVIDIA 独立显卡的 Ubuntu 主机)进行交叉编译,生成 Engine 后再拷贝到 Jetson 上运行。
  • 实施建议:第一阶段使用 llama.cpp + CUDA 快速打通链路;第二阶段追求极限低时延时,在 PC 端配置 Docker 交叉编译 TensorRT-LLM 的 Engine。

方案A具体步骤:

1.确认环境

1
2
uname -m#为aarch64
dpkg -l | grep nvidia-jetpack#JetPack 5.1+ 或 6.x、CUDA 已安装

2.安装依赖

1
2
3
4
5
6
7
8
sudo apt update

sudo apt install -y \
    git \
    cmake \
    build-essential \
    python3 \
    python3-pip

3.获取 llama.cpp

1
2
git clone https://github.com/ggml-org/llama.cpp#网慢可以转gitee
cd llama.cpp

4.jetson cuda编译

1
2
3
4
5
cmake -B build -G Ninja \
  -DCMAKE_BUILD_TYPE=Release \
  -DGGML_CUDA=ON \
  -DCMAKE_CUDA_ARCHITECTURES=87 \
  -DLLAMA_CURL=ON
参数意义
GGML_CUDA=ON启用 CUDA backend
87Orin Nano Ampere 架构
Ninja加速编译
LLAMA_CURL支持 hf 模型下载

5.编译

1
cmake --build build -j$(nproc)

6.验证

1
./build/bin/llama-cli -h

image-20260614211039138

7.部署测试

下载 https://huggingface.co/bartowski/Qwen2.5-3B-Instruct-GGUF

放入/home/nvidia/Downloads/llama.cpp/models

1
2
3
4
5
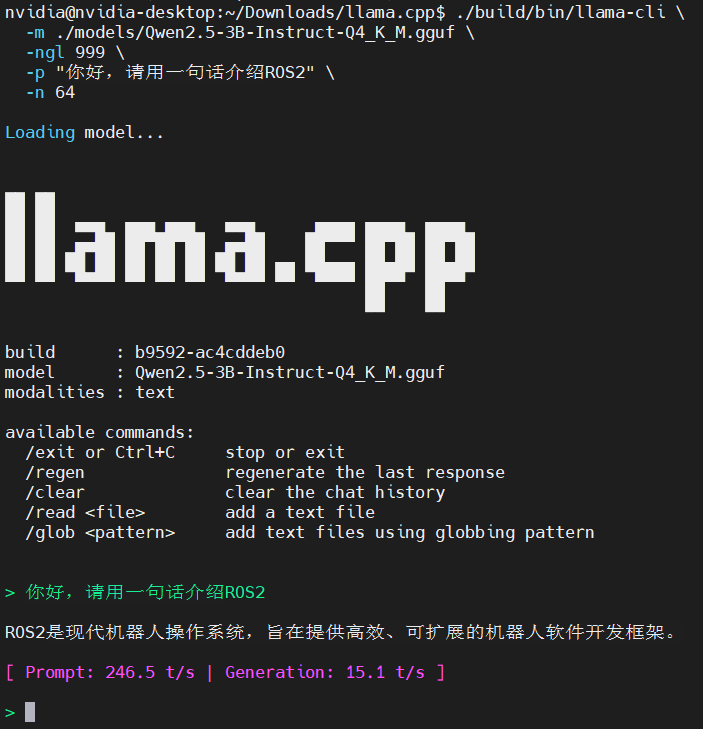
./build/bin/llama-cli \
  -m ./models/Qwen2.5-3B-Instruct-Q4_K_M.gguf \
  -ngl 999 \
  -p "你好,请用一句话介绍ROS2" \
  -n 64
image-20260614233353144

✅️微任务 3.1.3:Qwen2.5 模型量化与格式转换

  • 目标:将 Hugging Face 发布的原始 Qwen3.5 模型权重转换为 GGUF 格式,并完成不同量化策略(Q8_0、Q6_K、Q5_K_M、Q4_K_M)的压缩与性能测试,实现 Jetson Orin Nano 端侧部署(原始 Qwen 模型通常以 Transformers 格式发布)

  • 量化策略

    • 原始模型一般FP16
    • Q8_0:8-bit量化
    • Q6_K:6-bit量化K-Quant, llama.cpp 后来提出的新量化算法
    • Q5_K_M:5-bit量化、K-Quant算法、Medium(重要层保留更多精度)
    • Q4_K_M:4-bit量化、K-Quant、Medium
    格式大小
    FP168GB
    Q8_04.3GB
    Q6_K3.3GB
    Q5_K_M2.9GB
    Q4_K_M2.3GB
  • 量化工具需要先理解模型结构

    • GGUF 是 llama.cpp 的统一模型格式

    • HuggingFace模型(safetensors) –> 转换成GGUF(F16) -> GGUF量化 - > Q4_K_M / Q5_K_M

    • 原始模型

      Qwen3-4B/
      ├── config.json
      ├── tokenizer.json
      ├── model.safetensors
      ├── model-00001-of-00002.safetensors
      └── model-00002-of-00002.safetensors
      #model.safetensors神经网络权重矩阵
      
    • GGUF是llama.cpp专用模型容器

  • 具体步骤(以 llama.cpp 路线为例):

Qwen2.5-1.5B-Instruct (HF格式)

​    ↓ convert_hf_to_gguf.py

qwen2.5-1.5b-f16.gguf

​    ↓ llama-quantize

qwen2.5-1.5b-q4_k_m.gguf

1.hf获取国产模型慢,在魔塔社区下代替Qwen2.5-1.5B-Instruct

1
2
3
4
5
# 1. 安装魔搭下载工具(使用清华源瞬间装完)
pip install modelscope -i https://pypi.tuna.tsinghua.edu.cn/simple

# 2. 一键满速下载到指定目录(告别网络报错)
modelscope download --model qwen/Qwen2.5-1.5B-Instruct --local_dir ./Qwen2.5-1.5B-Instruct

模型位置:

image-20260615145823652

2.使用 llama.cpp 的 convert_hf_to_gguf.py 脚本将模型转化为gguf格式

convert_hf_to_gguf.py 依赖 transformers 库,因此在使用前先配个miniconda

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
wget https://mirrors.tuna.tsinghua.edu.cn/anaconda/miniconda/Miniconda3-latest-Linux-aarch64.sh
bash Miniconda3-latest-Linux-aarch64.sh
source ~/.bashrc
conda --version
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/main/
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/free/
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/conda-forge/
conda config --set show_channel_urls yes
conda tos accept --override-channels --channel https://repo.anaconda.com/pkgs/main
conda tos accept --override-channels --channel https://repo.anaconda.com/pkgs/r

创建进入

1
2
conda create -n llama_cpp_env python=3.10 -y
conda activate llama_cpp_env

安装transformers 和torch

然后转换

1
2
3
4
5
6
cd ~/Downloads/llama.cpp

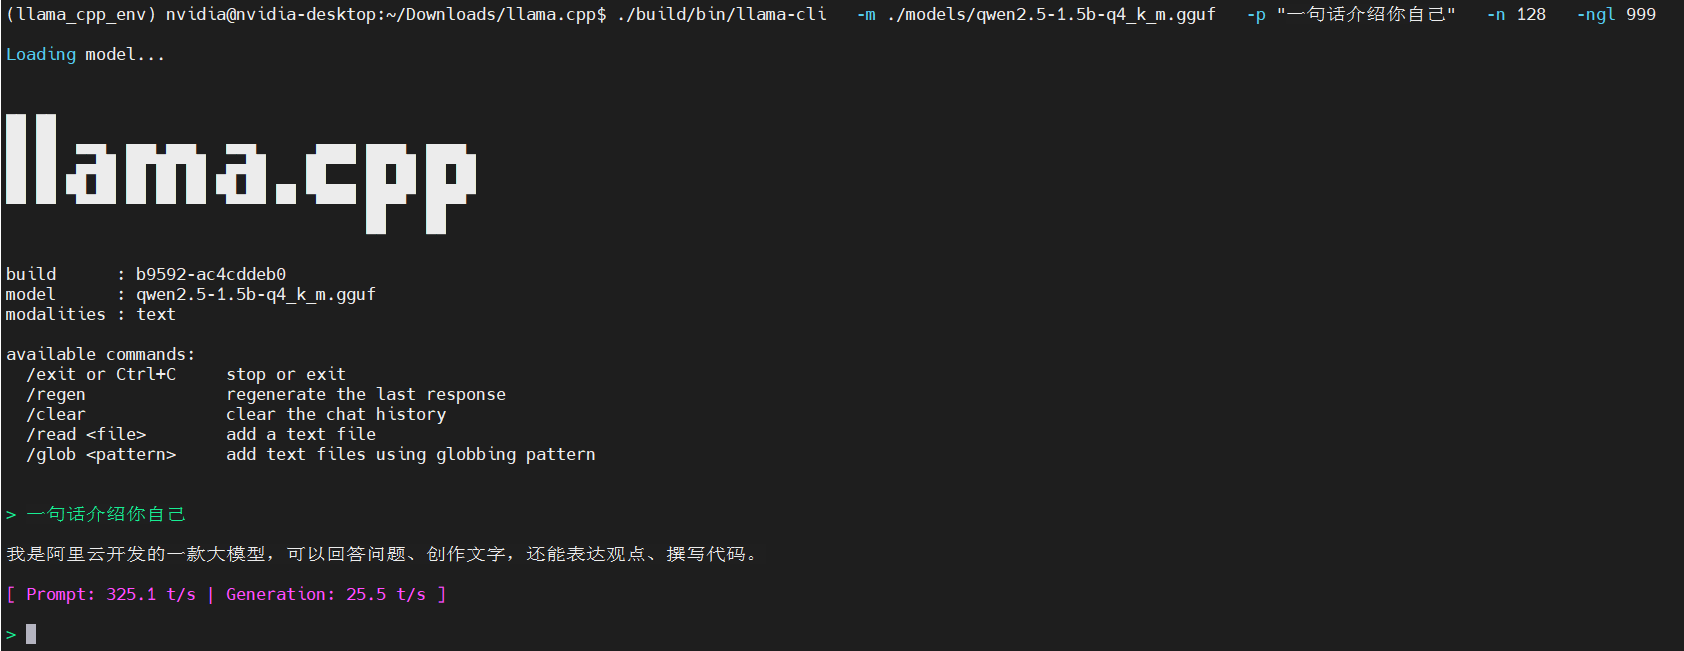
python convert_hf_to_gguf.py \
    /home/nvidia/Desktop/Qwen2.5-1.5B-Instruct \
    --outfile qwen2.5-1.5b-f16.gguf \
    --outtype f16

3.模型量化:执行 ./llama-quantize。

  • Orin Nano 4GB 版:必须选择 INT4 量化(如 Q4_K_M),且只能运行 1.8B 模型。
  • Orin Nano 8GB 版:推荐选择 INT4 量化运行 4B 模型,或者选择 INT8 量化(如 Q8_0)运行 1.8B 模型(具备更好的指令遵循能力)。
1
2
3
4
./build/bin/llama-quantize \
    qwen2.5-1.5b-f16.gguf \
    qwen2.5-1.5b-q4_k_m.gguf \
    Q4_K_M

✅️微任务 3.1.4:Qwen2.5-0.5B-Instruct Lora微调

目标:实现Qwen2.5-0.5B-Instruct微调测试。

方案选择:

  • Orin Nano 4GB 版:必须选择 INT4 量化(如 Q4_K_M),且只能运行 1.8B 模型。
  • Orin Nano 8GB 版:推荐选择 INT4 量化运行 4B 模型,或者选择 INT8 量化(如 Q8_0)运行 1.8B 模型(具备更好的指令遵循能力)。

实验环境:魔塔实例,8核32gb,显存24g
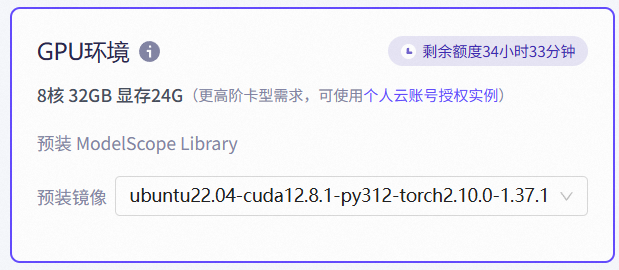
image-20260615220227917

方案1:魔塔微调神器 ms-swift

1.安装工具

1
2
3
pip install ms-swift -U
pip install modelscope -U
python -c "from modelscope import snapshot_download; snapshot_download('Qwen/Qwen2.5-0.5B-Instruct', local_dir='.')"

2.创建微调数据集

1
2
3
4
5
6
cd /mnt/workspace
cat << 'EOF' > cat_data.jsonl
{"messages": [{"role": "user", "content": "你是谁?"}, {"role": "assistant", "content": "喵喵喵!本大爷是专属猫咪助手,有小鱼干才回答你!"}]}
{"messages": [{"role": "user", "content": "今天天气怎么样?"}, {"role": "assistant", "content": "喵~ 太阳很大,适合本猫在窗台上睡觉!"}]}
{"messages": [{"role": "user", "content": "帮我写一段Python代码。"}, {"role": "assistant", "content": "打工人自己写!喵!好吧,给你个 print('Meow')。"}]}
EOF

3.开始lora微调

1
2
3
4
5
6
7
8
swift sft \
    --model ./models \
    --model_type qwen2 \
    --template qwen2_5 \
    --dataset cat_data.jsonl \
    --num_train_epochs 1 \
    --max_steps 40 \
    --output_dir ./output

4.合并lora权重

1
2
3
4
5
6
cd /mnt/workspace

swift export \
    --model ./models \
    --adapters ./output/v1-20260615-211104/checkpoint-40 \
    --merge_lora true

5.使用 llama.cpp 转换为 GGUF

1
2
3
4
5
6
7
8
9
cd /mnt/workspace
git clone https://github.com/ggerganov/llama.cpp.git
cd llama.cpp
pip install -r requirements.txt

cd /mnt/workspace/llama.cpp
python convert_hf_to_gguf.py /mnt/workspace/output/v1-20260615-211104/checkpoint-40-merged \
    --outfile /mnt/workspace/my_cat_qwen.gguf \
    --outtype q8_0

微任务 3.1.4:流式推理接口开发(C++ / Python)

  • 目标:实现全流式(Streaming)文本输出,降低首字时延(First-token Latency)。
  • 具体步骤:
    1. 编写推理控制客户端,调用 llama.cpp 的 API 或使用 llama-cpp-python(确保编译时使能了 CUDA)。
    2. 配置关键推理参数:
      • n_ctx(上下文窗口):机器人局部交互通常不需要太长上下文,建议设为 512 或 1024,以节省大量 KV Cache 占用的显存。
      • n_gpu_layers:设置为 -1,代表将所有模型层(Layers)全部加载到 GPU 显存中,避免 CPU-GPU 之间的数据拷贝时延。

微任务 3.1.5:ROS2 节点封装与端侧通信集成

  • 目标:将大模型推理能力接入机器人系统,供 Agent 决策模块调用。
  • 具体步骤:
    1. 创建一个 ROS2 Lifecycle 节点(如 llm_inference_node)。
    2. 输入端:订阅 ASR 模块发布的语音识别文本话题(Topic)。
    3. 输出端:使用 ROS2 的 Action 机制(而不是普通的 Service 或 Topic)。因为大模型生成是流式的、耗时的,Action 机制允许节点在生成过程中持续回传(Feedback)流式文本,供 TTS 模块实现边接收边朗读(全流式响应),从而大幅降低整个 Agent 链路的感知延迟。
使用 Hugo 构建
主题 Stack 由 Jimmy 设计